从预测一个分子,到设计一个药物。过去几十年,抗体药物发现的核心逻辑并没有发生根本改变。无论是杂交瘤技术、噬菌体展示,还是单B细胞筛选,本质上都在回答同一个问题:如何从巨大的分子空间中,找到那个足够好的抗体?过去几十年的抗体发现不断走向规模化,我们不断构建更大的抗体库、更高通量的筛选体系、更复杂的实验平台——从千鼠万抗的杂交瘤筛选,到百亿级展示库的定向探索,本质上都是希望通过扩大搜索空间,提高发现优质候选分子的概率。
理论上的抗体序列空间几乎无限,而现实中能够被合成、表达并通过实验验证的分子,只占其中极其微小的一部分。真正限制抗体发现效率的,也许从来不是我们能够产生多少序列,而是我们是否知道,哪些序列值得被创造。AI正在改变这个问题,而大湾生物希望再向前走一步。如果AI不仅能够预测一个抗体的性质,而是开始理解什么样的分子更可能成为药物,会发生什么?这正是大湾生物构建AI驱动的生物药发现平台的起点。
1. 从筛选走向设计
传统抗体发现,是一个典型的“先产生、再筛选”的过程。产生大量候选分子,通过实验不断筛选、验证、淘汰,最终逐渐收敛到少数候选物。这种模式推动了抗体药物产业的发展,也建立了成熟的研发体系。
但随着靶点复杂度提升、多特异抗体和新型生物药不断发展,传统依赖规模扩张的方式正在面临新的挑战。因为更大的库,并不一定意味着更好的答案,更多的实验,也不一定意味着更快的发现。
AI带来的变化,并不只是让这个过程更快,更重要的是,它开始改变搜索本身。大湾生物正在尝试建立一种新的抗体发现路径:靶点生物学解析 → 分子设计假设 → AI智能设计 → 实验验证 → 生物学反馈 → 新一代分子优化。在这个过程中,AI不再只是研发流程末端的一个预测工具,它开始进入分子产生的源头,大湾生物由此建立了以AlfaBodY和AlfaDAX为核心的AI抗体发现与分子工程体系,但这套体系真正重要的部分并不是某一个模型,甚至不是某一种算法,而是模型背后的系统。
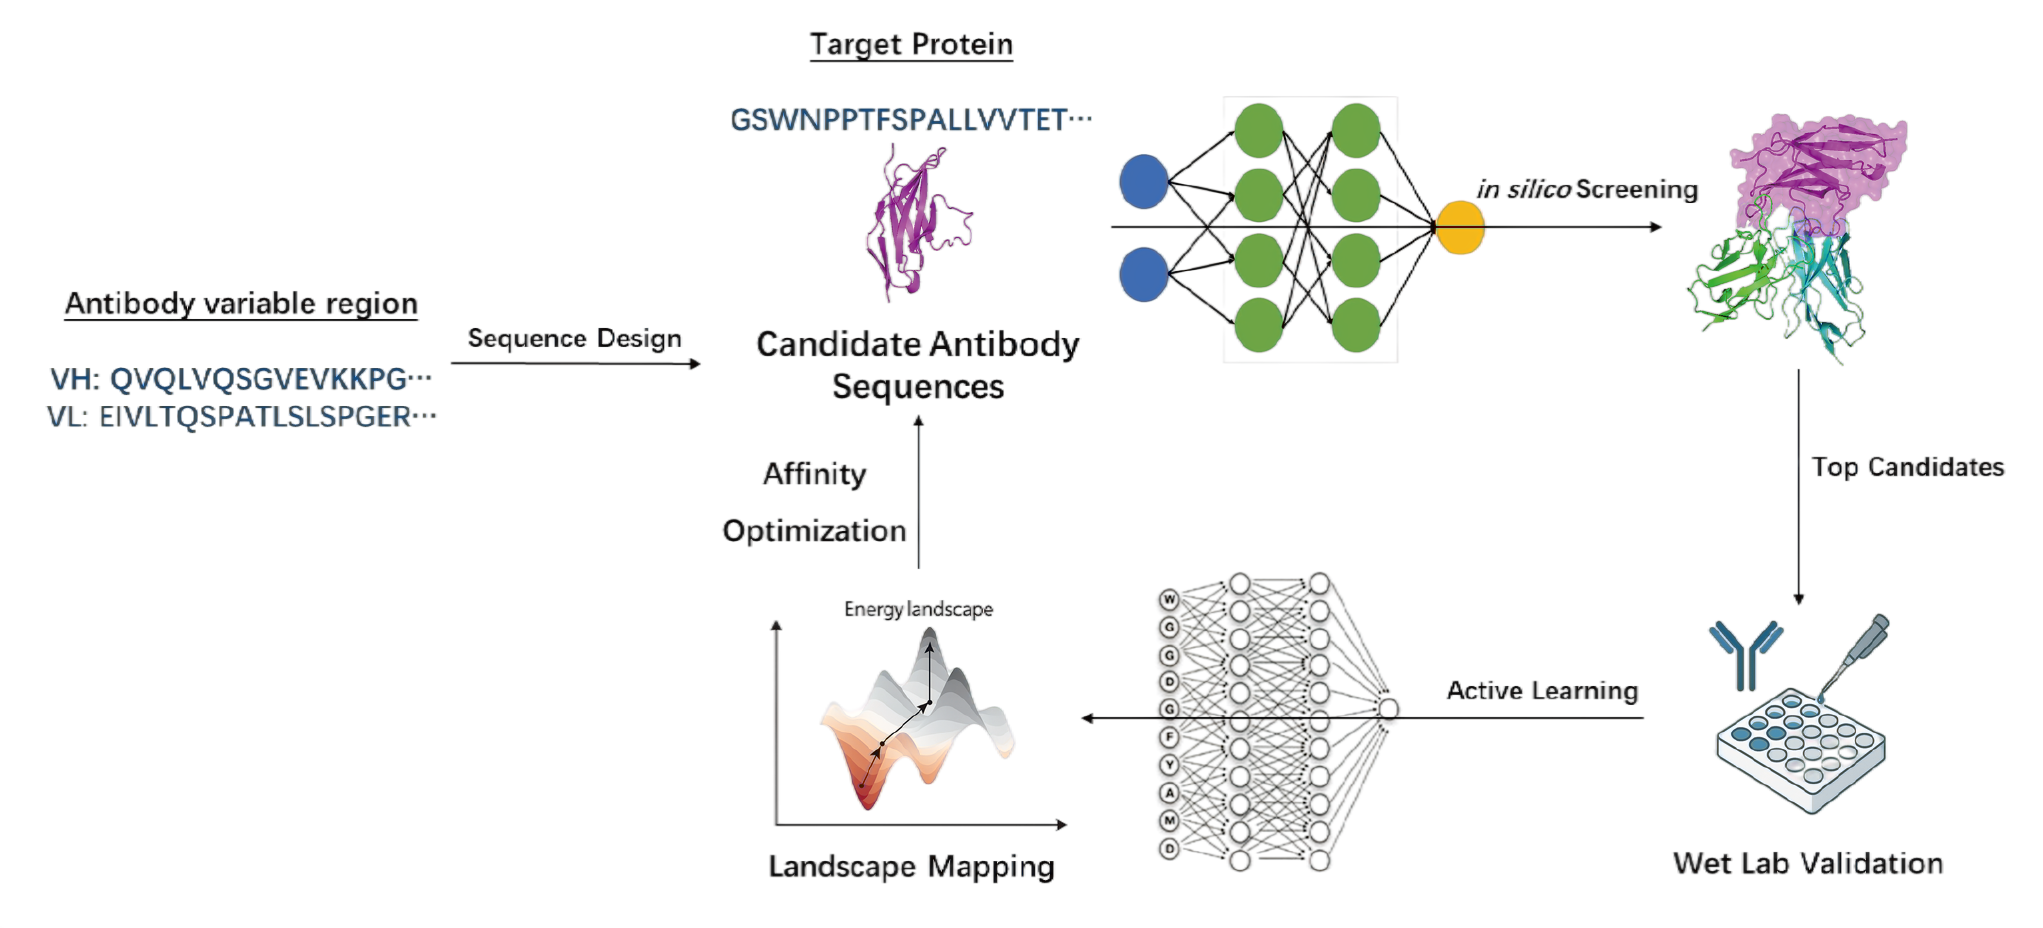
▲图1:AlfaBodY平台聚焦抗体从0到1的智能设计,通过AI算法探索更具潜力的抗体序列
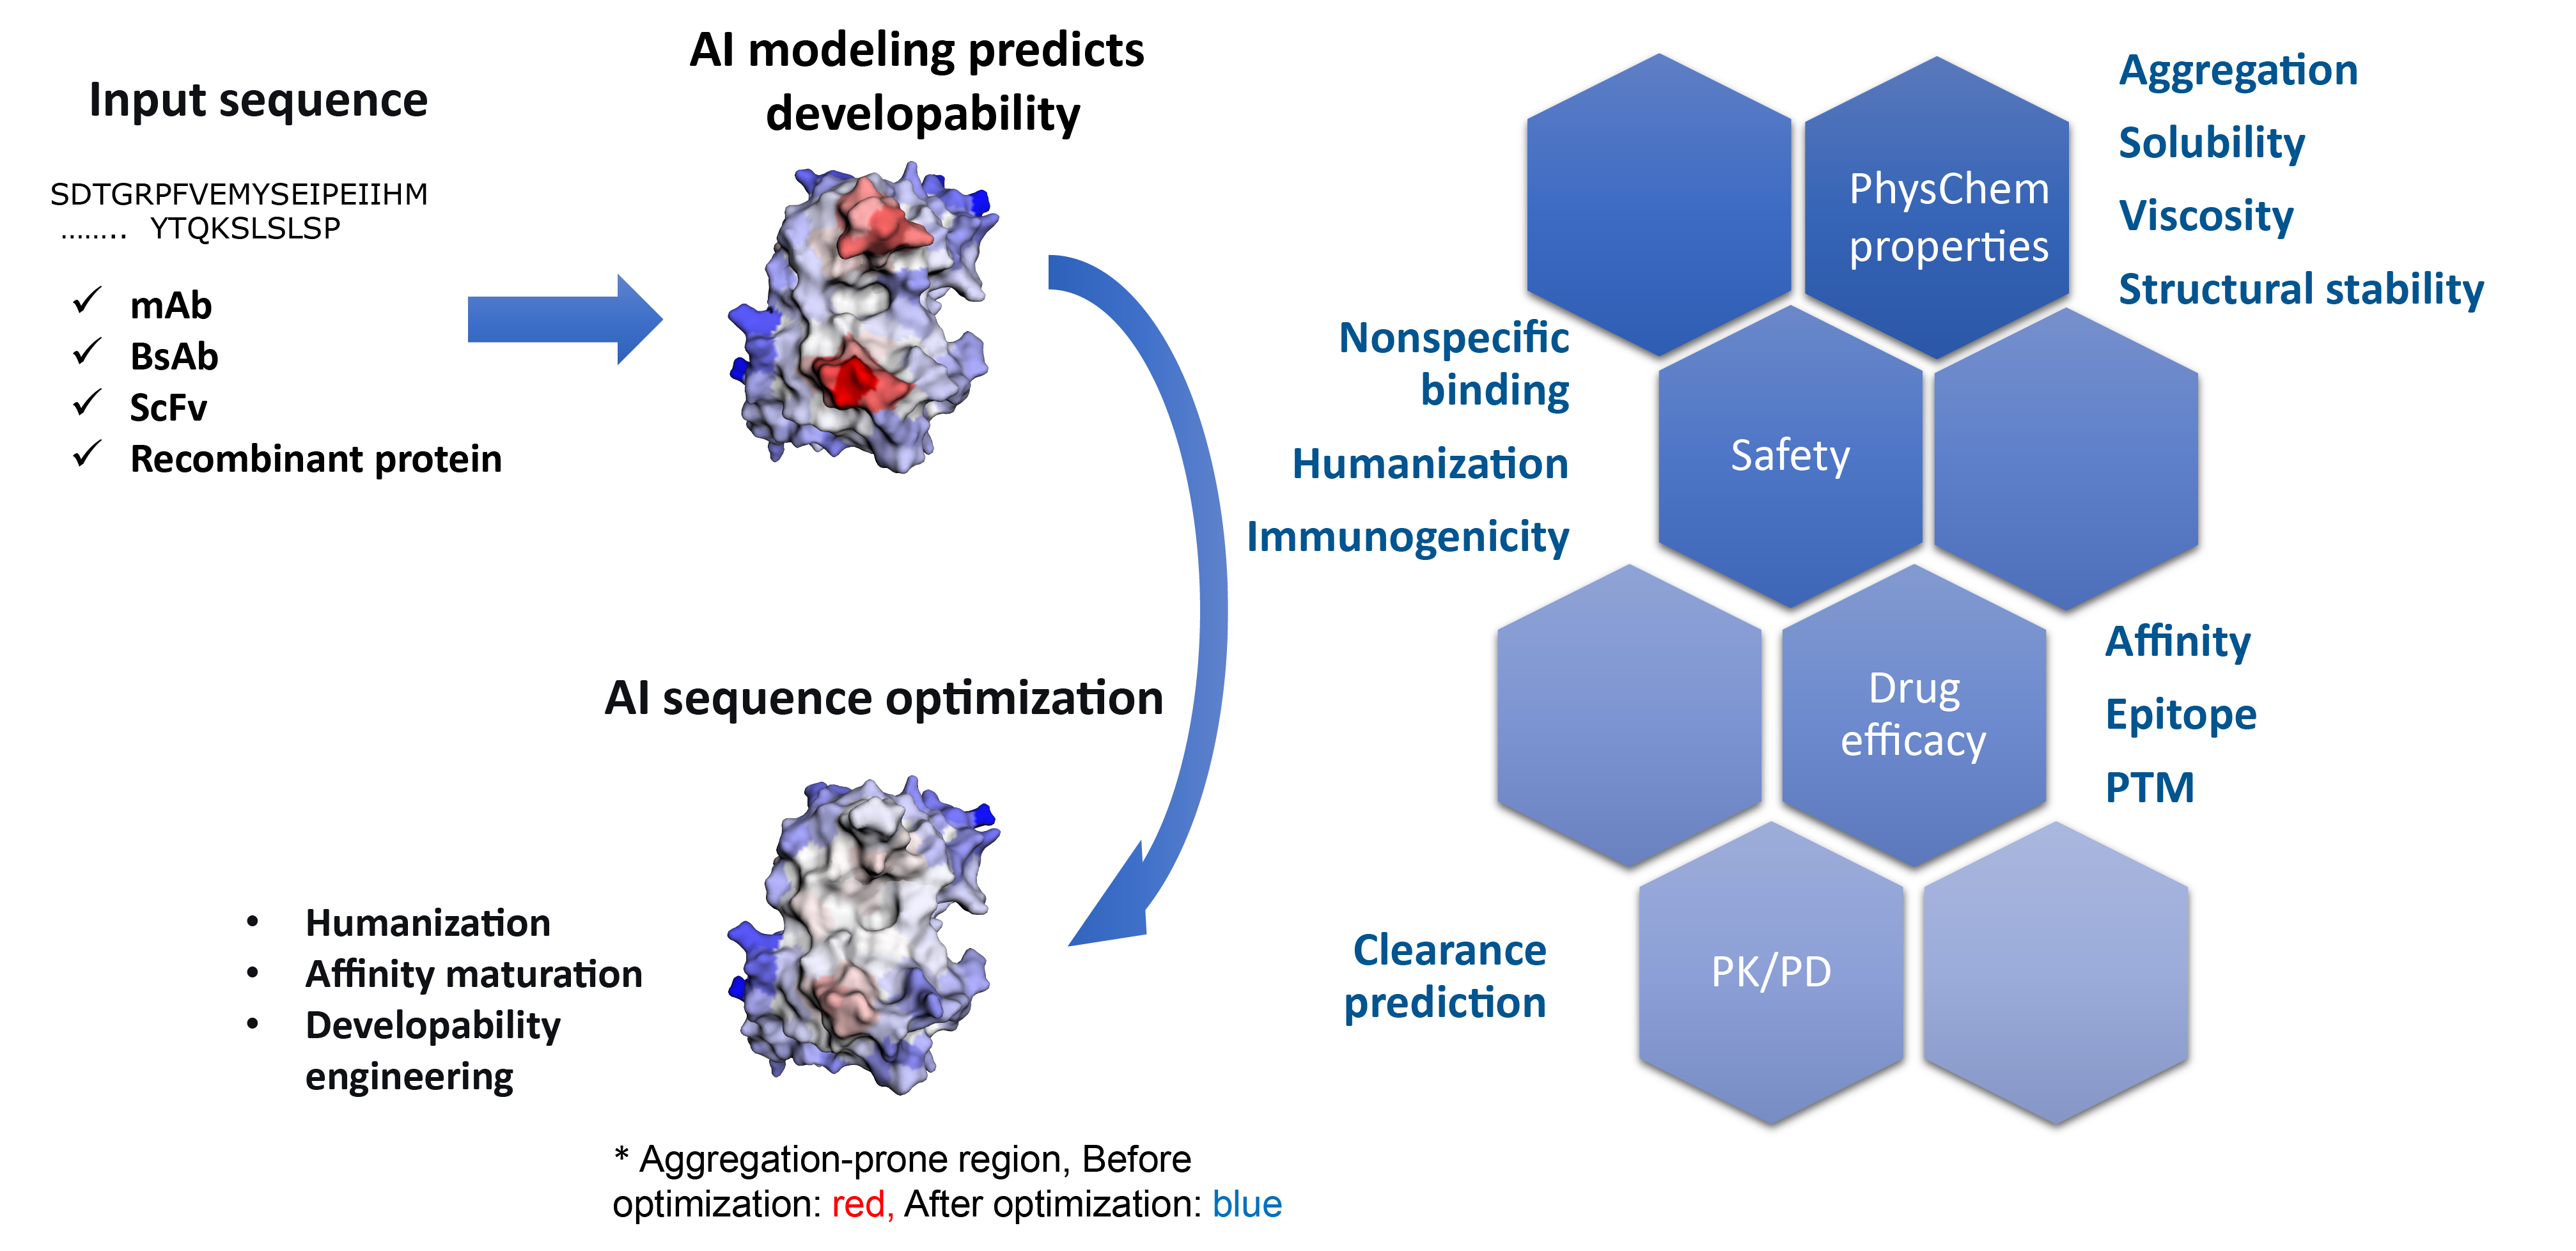
▲图2:AlfaDAX平台面向抗体分子优化,在亲和力、人源化及成药性等多个维度进行综合优化
2. Biology-native AI:不仅是一个模型,而是一套系统
今天,AI已经可以生成蛋白质序列、预测结构、分析分子性质。于是,一个自然的问题出现了,是不是模型足够大、参数足够多、训练数据足够丰富,就能够设计出更好的药物?
大湾生物的答案并没有这么简单,因为生物药研发从来不是一个单变量问题。一个真正具有开发潜力的抗体,需要同时面对多个彼此关联、甚至彼此冲突的约束,包括结合能力、表位特征、功能活性、特异性、稳定性、聚集风险、黏度特性、表达能力、成药性潜力等。一个在某个指标上接近“完美”的分子,完全可能在另一个维度失去成为药物的可能性。
因此,大湾生物没有试图寻找一个解决所有问题的超级模型,我们选择了另一条路径——一套围绕真实生物学规律构建的专业化AI引擎体系。针对不同的生物学问题,建立不同的算法能力,让这些能力在真实项目中持续验证,再让不同任务产生的知识,在同一个平台中不断积累。我们将这一体系称为Biology-native AI,它不是让AI脱离生物学去“想象”一个药物,而是让AI在真实的生物学约束中,逐渐学习如何设计一个药物。
3. 更多数据未必意味着更多信息
过去十年,AI领域形成了一个极具影响力的范式,更大的数据+更大的模型+更多的计算=更强的能力。但生命科学可能有所不同,公开数据库中存在海量蛋白质序列和结构信息。然而,对于药物设计而言,真正有价值的问题往往不是这个蛋白长什么样?而是为什么这个序列发生一个变化后,活性提高了?为什么两个亲和力相似的抗体,在可开发性上表现完全不同?为什么一个计算上看起来优秀的分子,在真实实验中失败了?这些问题背后的数据往往没有那么“大”,甚至可能只是几十个序列、几组突变、一次表达结果或者一次失败的实验,但它们拥有另一种属性——高信息密度(High Information Density)。
因此,大湾生物关注的不只是大数据,我们更加关注高质量、高价值的生物学数据。这些来自真实研发过程的数据,具有明确的实验条件、分子背景和生物学结果。更重要的是它们能够告诉AI什么有效,什么无效,以及为什么,这可能比单纯增加数据规模更加重要。
4. 每一次实验都不应该只产生一个实验结果
传统研发体系中,一次实验通常只有一个直接目的,判断这个分子是否值得继续。在AI驱动的研发体系中,大湾生物希望一次实验至少产生两种价值,第一种价值是评价分子,第二种价值是让系统学习。
大湾生物将计算设计与实验验证构建为一个持续循环,AI设计 → 聚焦式实验验证 → 生物学反馈 → 主动学习 → 下一轮设计循环。AI提出假设,实验验证假设,实验结果重新定义下一轮需要探索的分子空间。
一个项目的终点,也可能成为另一个项目的起点。在大湾生物内部,我们越来越少把AI理解成一个单独的软件工具,我们更愿意把它看成一个不断学习的设计引擎,真正有价值的AI系统,并不是替代实验,而是让每一次实验,都成为下一轮设计能力提升的一部分。
5. 不是多生成序列,而是少做无效实验
AI生成蛋白质序列正在变得越来越容易,未来生成一百万条甚至一亿条序列,可能都不再是一件困难的事情,但这并不意味着药物发现会自动变得更快。因为最终仍然需要回答哪一些分子值得真正进入实验?如果AI生成了100万条序列,最终仍然需要大量实验逐一筛选,那么AI改变的可能只是序列产生方式,而没有真正改变研发效率,真正改变研发效率的关键,并不是让实验规模无限扩大,而是在进入实验之前,通过AI最大程度提高候选分子的选择质量。
Nature文献《The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies》提到,在基于AI Agent的抗体设计流程中,通常需要约1周完成pipeline运行,随后还需要约6周以上的湿实验验证以及进一步的数据分析与迭代(参考图3)。在大湾生物AI驱动的研发体系中,自动化pipeline能够将计算流程优化至约2天完成,并结合智能化实验体系,将后续湿实验验证周期进一步压缩至2周,实现从1周+6周到2天+2周的整体效率提升(参考图1)。这意味着,AI带来的价值并不是简单替代实验,而是在实验开始之前,帮助研发团队更精准地决定哪些分子值得被创造、哪些实验值得被执行、哪些研发路径值得投入。
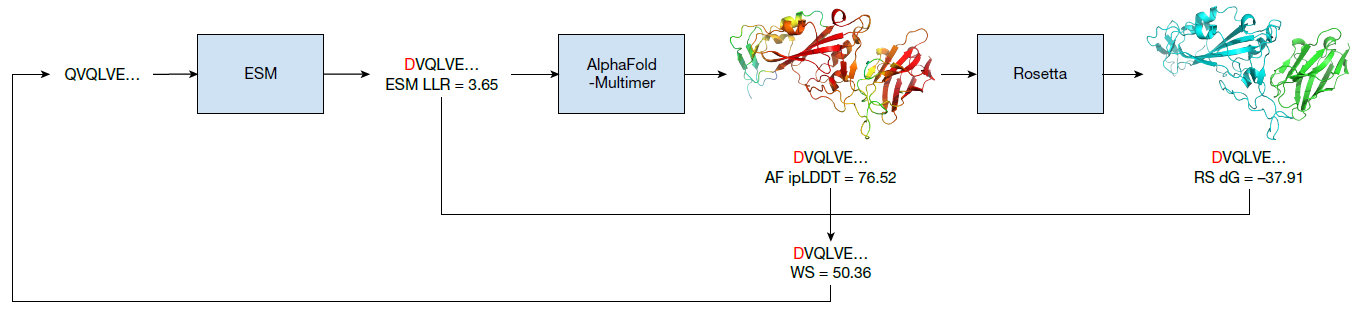
图3:Nature文献《The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies》基于AI Agent的抗体设计流程图
大湾生物关注的并不是AI能够生成多少条序列,而是我们需要验证更少的候选分子,这背后是完全不同的技术逻辑,AlfaBodY将靶点信息、分子特征、已有生物学知识以及历史实验反馈映射到一个更加聚焦的设计空间。AI不是简单地产生更多候选物,而是在巨大的理论空间中,不断缩小真正值得实验验证的区域。我们希望最终实现的是更少的候选分子,更高的信息密度,更优的研发决策,这可能才是AI对于抗体发现真正重要的意义。
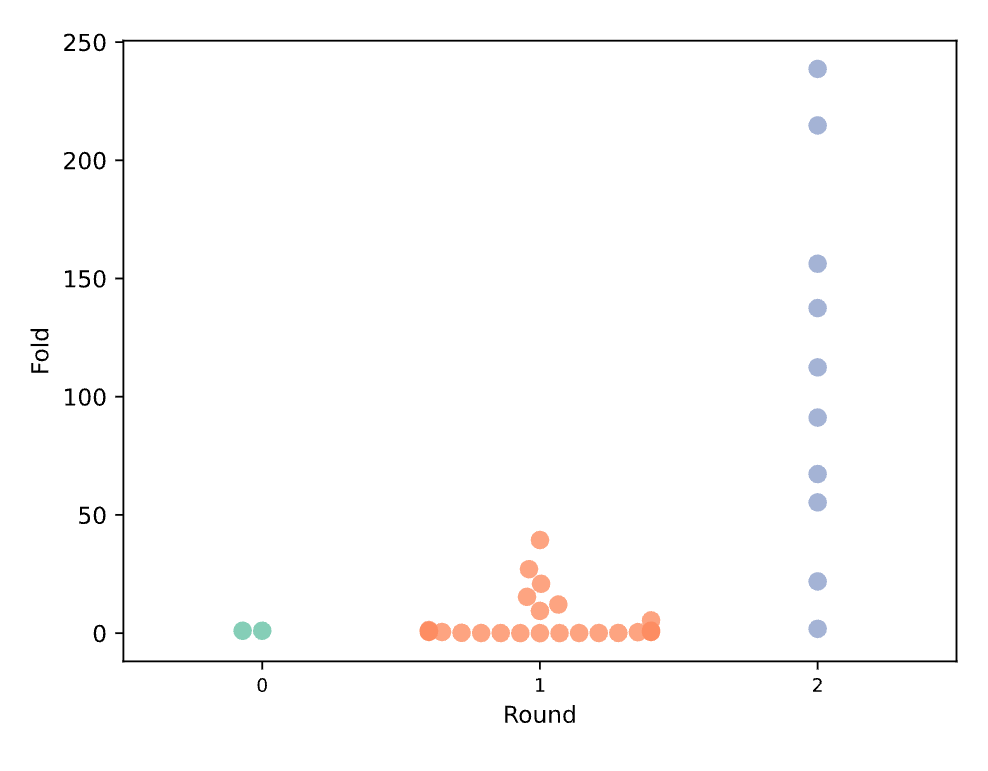
▲图4:大湾生物AlfaDAX平台在1个多月内完成2轮优化,亲和力提升了200倍
6. 好的抗体,不是一个指标的冠军
抗体工程还有另一个长期存在的问题,单目标优化。提高亲和力、提高活性、降低聚集、降低黏度、改善表达等,这些问题过去往往被分阶段、逐个解决,但药物并不是这些指标的简单相加。一个突变可能提高亲和力,却同时降低稳定性,另一个突变可能改善表达,却影响生物学活性。真正的分子设计,本质上是一个复杂的多目标优化问题。
因此,AlfaDAX关注的并不是怎样让这个抗体的某一个指标做到最好,而是什么样的分子属性组合,才能创造出最佳的药物候选分子。当亲和力、活性、稳定性、聚集、黏度、表达以及其他关键属性被放到同一个设计空间中,AI面对的就不再是寻找某个单一指标的极值,而是在复杂的分子空间中寻找帕累托最优分子解。换句话说,我们优化的不是一个参数,我们优化的是成为药物的可能性。
7. AI真正难以复制的壁垒,也许是复利
一个模型训练完成之后,它的能力基本确定,但一个平台不应该如此。一个新的抗体项目进入系统,产生新的设计,新的设计进入实验,实验产生新的生物学反馈,这些反馈重新验证模型,模型又影响下一轮设计,形成更优质的数据 → 更先进的算法 → 更优质的分子 → 更多生物学验证 → 更优质的数据,大湾生物将这种现象称为AI能力复利(AI Capability Compounding)。
真正重要的,不是某一次预测究竟提高了几个百分点,而是当几十个、几百个真实研发任务不断进入同一个体系之后,系统是否能够持续积累对于序列 → 结构 → 功能 → 成药性潜力之间关系的理解。如果答案是肯定的,那么AI平台真正积累的就不再只是数据。而是一种越来越难以复制的智能生物学设计,这也是AI驱动生物药研发区别于传统计算工具的核心,工具解决单个问题,而平台能够持续进化。
8. 生物药AI自己的规模定律
在通用人工智能领域,规模定律告诉我们随着数据、模型参数和计算资源的扩大,模型能力可能持续提升,但药物研发是否遵循完全相同的规律?我们认为,这个问题仍然值得探索。因为在生物学中,一个经过真实实验验证的数据点,与一个未经验证的数据点,并不具有完全相同的信息价值。一个能够改变分子设计决策的数据点,也可能比成千上万个普通序列更加重要。
大湾生物正在思考另一种可能生物AI的发展,也许并不仅取决于模型接触了多少数据,而取决于它从多少经过实验验证的生物学规律中学习。这意味着,Biology-native AI真正的规模定律,也许并不仅仅来自更多数据×更大模型×更多计算资源,还来自更优质的数据×专业化算法×实验验证×持续学习,这不是一个已经完成的公式,而是大湾生物正在真实研发环境中不断验证的方向。
未来,生物药AI的发展,可能不会简单遵循传统AI“大模型、大数据”的增长路径。真正决定平台能力的,也许是能否持续获得高质量生物反馈,能否让算法理解真实实验,能否让每一次研发实践推动下一次创新。
9. 从预测生物学到工程化设计生物药
AI进入生命科学之后,我们经历了几个阶段。最早,我们希望AI能够帮助我们分析数据,后来,我们希望AI能够预测生物学,再后来,生成式AI开始尝试创造新的分子。但对于大湾生物而言,更值得期待的下一步是工程化设计生物药,让AI真正进入生物药工程体系,不是单独存在于计算端,而是与抗体发现、分子工程、实验验证以及后续CMC开发逐渐连接起来。
从AlfaBodY的抗体序列设计,到AlfaDAX的多目标分子优化,再到真实实验产生的持续反馈,大湾生物正在构建的并不是一个单独的AI模型,而是一套能够持续进化的AI驱动的生物药发现与工程平台。我们并不知道AI最终会把生物药研发带到哪里,但有一点正在变得越来越清晰,未来真正具有价值的AI药物研发平台,也许不会仅仅由谁拥有最大的模型决定,而是谁能够最快从生物学中学习,当每一次分子设计都产生新的实验数据,当每一次实验都反过来改变下一次设计,当数据、算法与生物学开始形成持续闭环,AI所做的事情,也许就不再只是预测生物学可能会发生什么,而是开始走向工程化创造生命可能成为的未来。
让AI深入连接抗体发现、分子优化、实验验证及CMC开发流程,通过自主蛋白设计与智能化研发体系,大湾生物致力于提高候选分子命中率,减少研发成本,加速创新生物药开发。


